Introduzione al Machine Learning
Passare dal Data Mining al Machine Learning non significa semplicemente adottare nuove tecnologie, ma trasformare il modo in cui l'azienda utilizza i propri dati. Il Data Mining consente di individuare pattern e relazioni nei dati storici, mentre il Machine Learning permette di costruire modelli capaci di apprendere automaticamente e generare previsioni sempre più accurate nel tempo. Investire nella formazione aiuta le persone a comprendere questo cambiamento culturale e metodologico, rendendole in grado di sfruttare al meglio il valore delle informazioni aziendali.
La formazione è fondamentale perché il Machine Learning richiede competenze diverse rispetto alle tradizionali tecniche di analisi dei dati. I collaboratori devono imparare a preparare i dataset, scegliere gli algoritmi più adatti, valutare le prestazioni dei modelli e interpretarne correttamente i risultati. Senza un adeguato percorso formativo, il rischio è quello di investire in strumenti avanzati senza ottenere benefici concreti. Un personale preparato, invece, è in grado di trasformare i dati in conoscenza e la conoscenza in decisioni operative più efficaci.
Infine, investire nello sviluppo delle competenze di Machine Learning significa aumentare la competitività dell'impresa. Le organizzazioni che sanno prevedere vendite, individuare anomalie, anticipare guasti o personalizzare offerte e servizi possono reagire più rapidamente ai cambiamenti del mercato e migliorare i propri risultati. La formazione rappresenta quindi un investimento strategico che consente di valorizzare il capitale umano, accelerare l'innovazione e creare un vantaggio competitivo sostenibile nel lungo periodo.
La struttura del corso
Il corso si struttura su 10 moduli formativi per un totale di circa 40 ore di formazione. Si parte dalle basi del data mining per poi vedere come questo si evolve e trova uno sbocco naturale nel machine learning in base alle esigenze delle aziende di oggi.
Per svolgere il percorso ci appoggeremo a Microsoft Excel, di cui è presupposta una buona o ottima conoscenza ed "evolveremo" in Orange, uno strumento free per svolgere attività di data mining e nel nostro caso anche di Machine Learning. La scelta è caduta su questo prodotto per due ragioni, la prima sicuramente perchè non prevede alcun impegno economico da parte dell'azienda per la partecipazione al percorso, ma soprattutto perchè consente di lavorare senza dover fare ricorso a nessuna competenza di programmazione; tutto quello che faremo lo faremo in modo visuale, inserendo oggetti e personalizzandoli secondo le nostre esigenze.
Modulo 1
I dati come materia prima
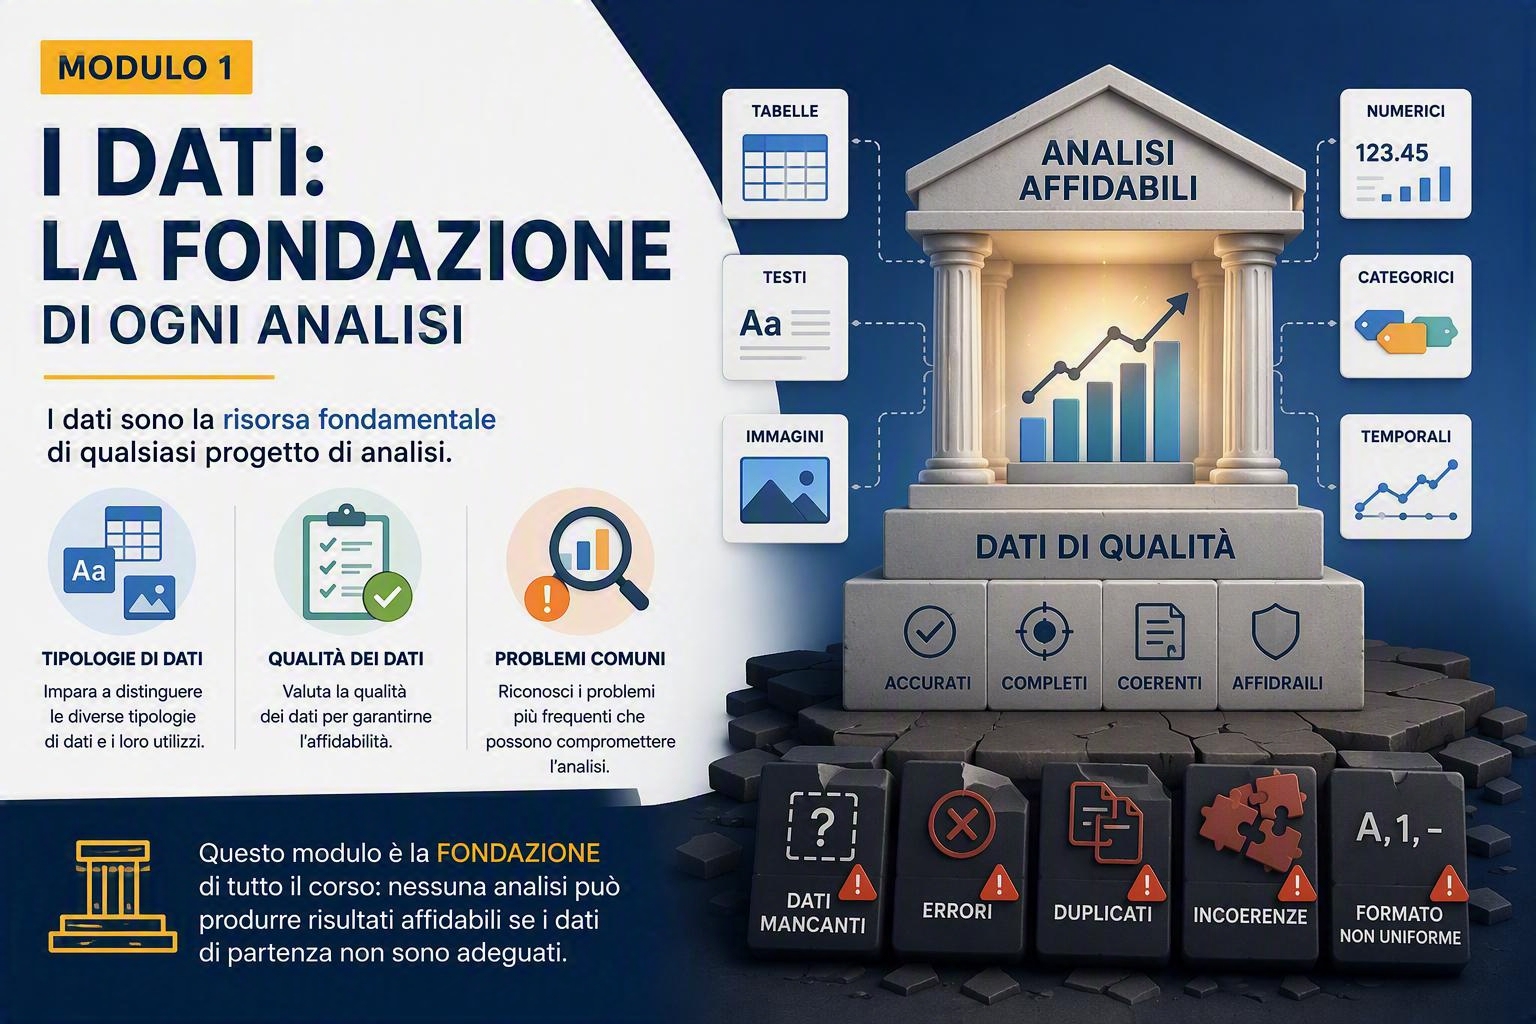
Inizieremo il nostro percorso comprendendo cosa sono i dati e perché rappresentano la risorsa fondamentale di qualsiasi progetto di analisi. Impareremo a distinguere le diverse tipologie di dati, a valutarne la qualità e a riconoscere i problemi più frequenti che possono comprometterne l'utilizzo. Questo modulo costituisce le fondamenta di tutto il corso, perché nessuna analisi può produrre risultati affidabili se i dati di partenza non sono adeguati.
Modulo 2
Introduzione al data mining
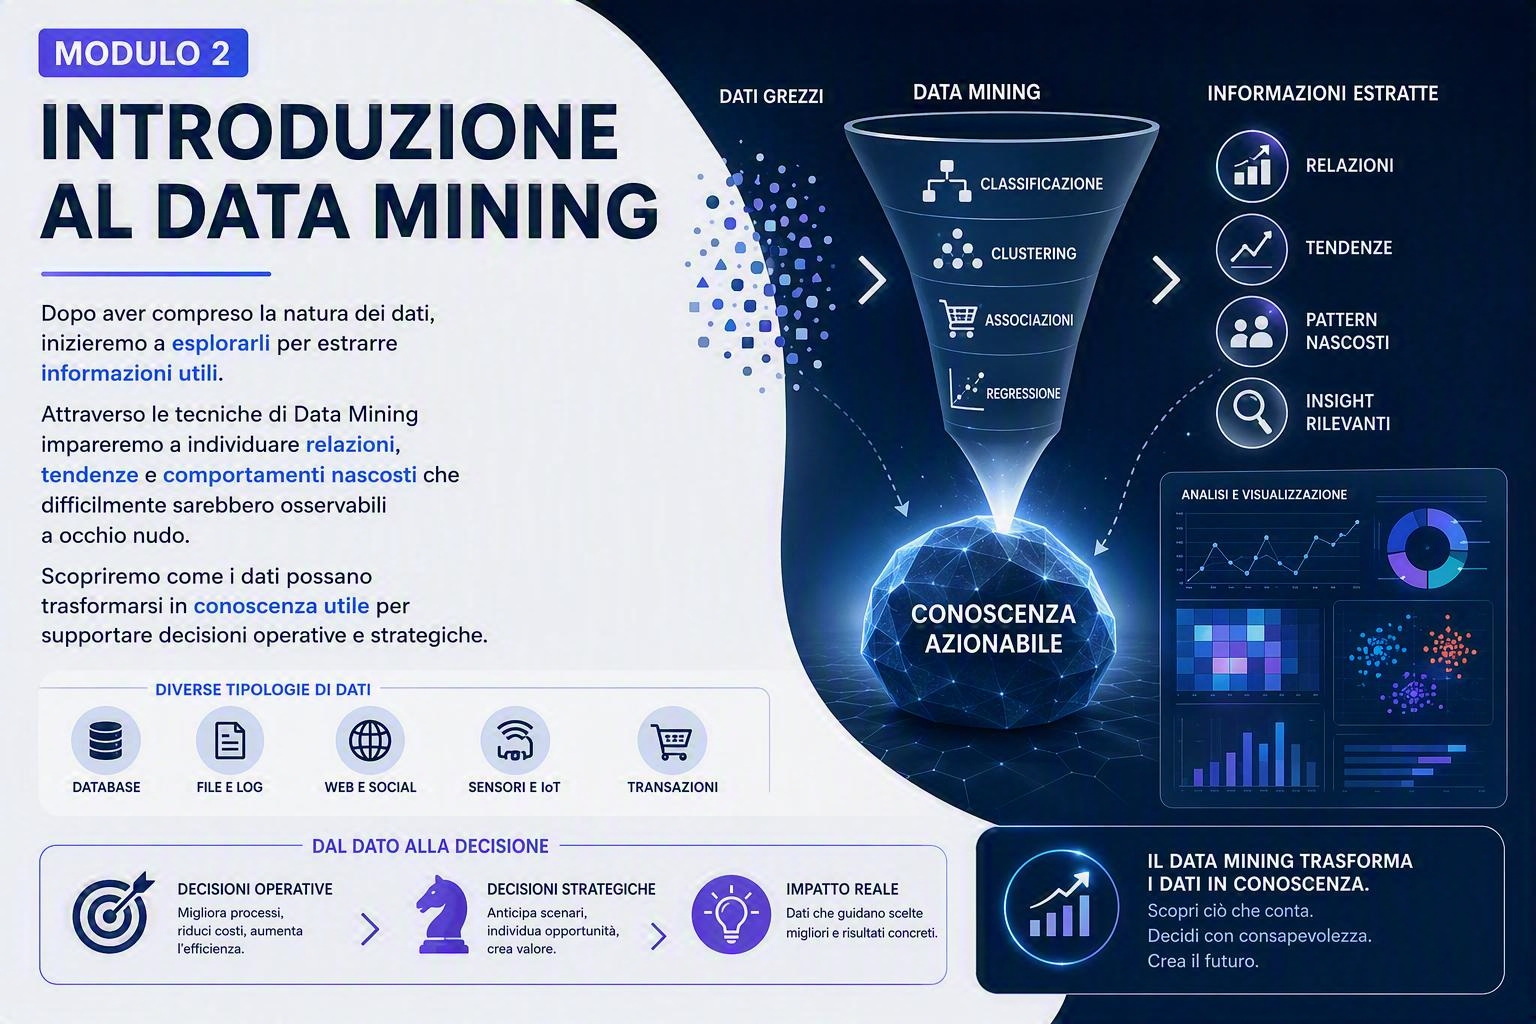
Dopo aver compreso la natura dei dati, inizieremo a esplorarli per estrarre informazioni utili. Attraverso le tecniche di Data Mining impareremo a individuare relazioni, tendenze e comportamenti nascosti che difficilmente sarebbero osservabili a occhio nudo. Scopriremo come i dati possano trasformarsi in conoscenza utile per supportare decisioni operative e strategiche.
Modulo 3
Data preparation
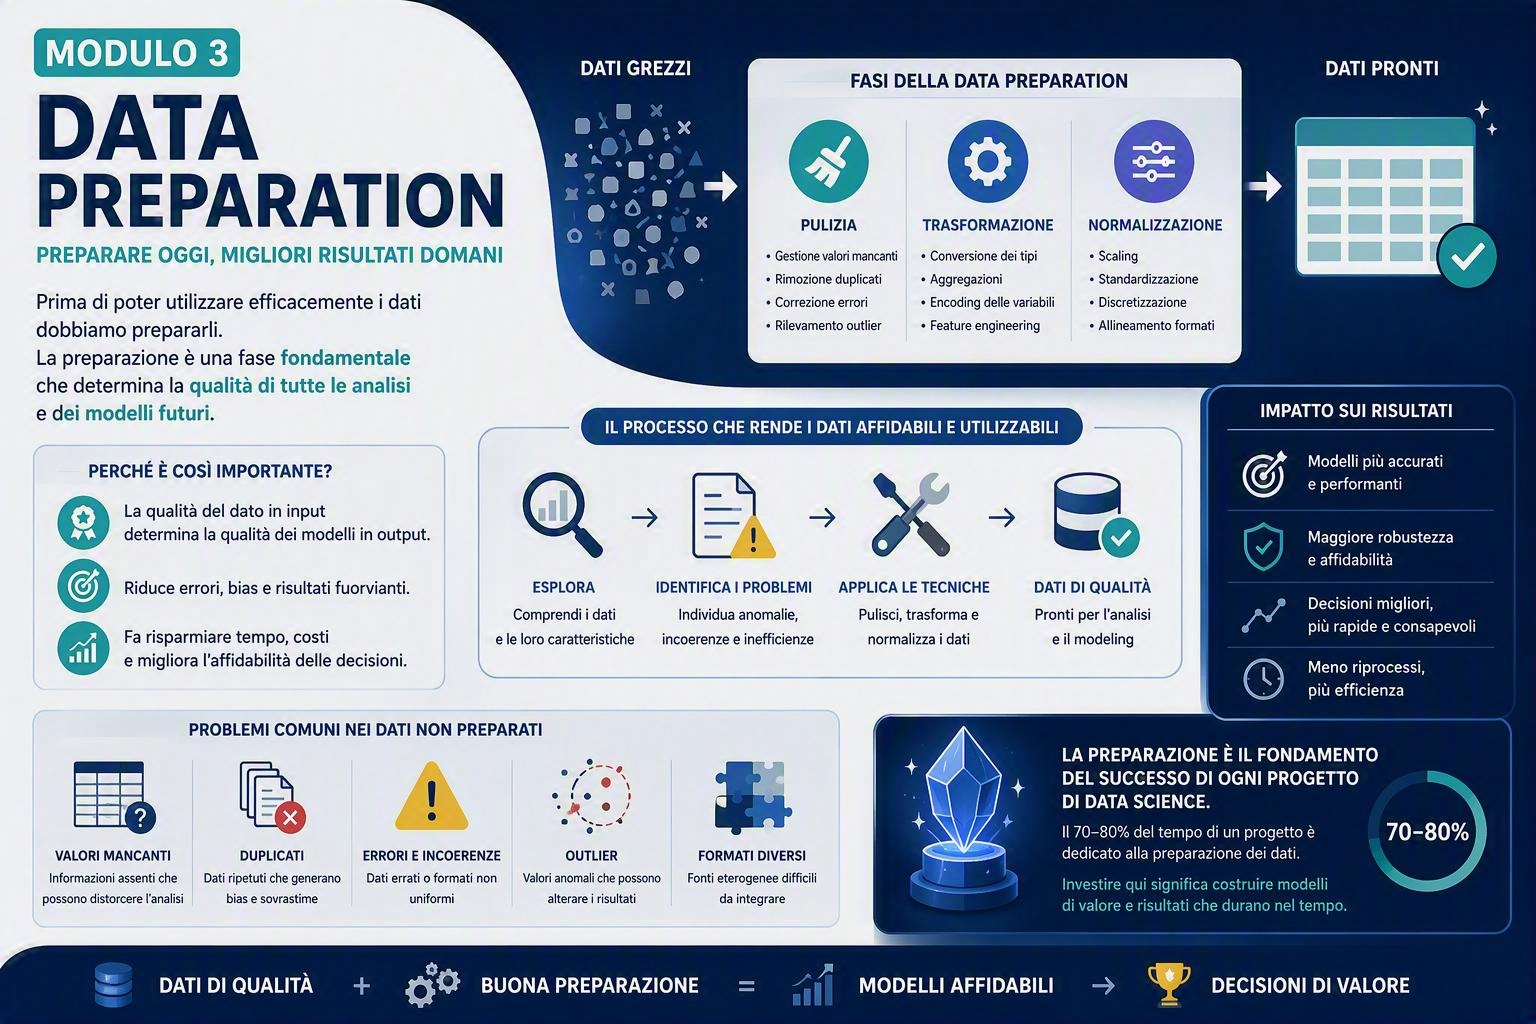
Prima di poter utilizzare efficacemente i dati dobbiamo prepararli. In questo modulo comprenderemo l'importanza delle attività di pulizia, trasformazione e normalizzazione. Scopriremo che la preparazione dei dati rappresenta una delle fasi più importanti e impegnative di ogni progetto di Data Science e che la qualità dei modelli futuri dipenderà direttamente dalla qualità del lavoro svolto in questa fase.
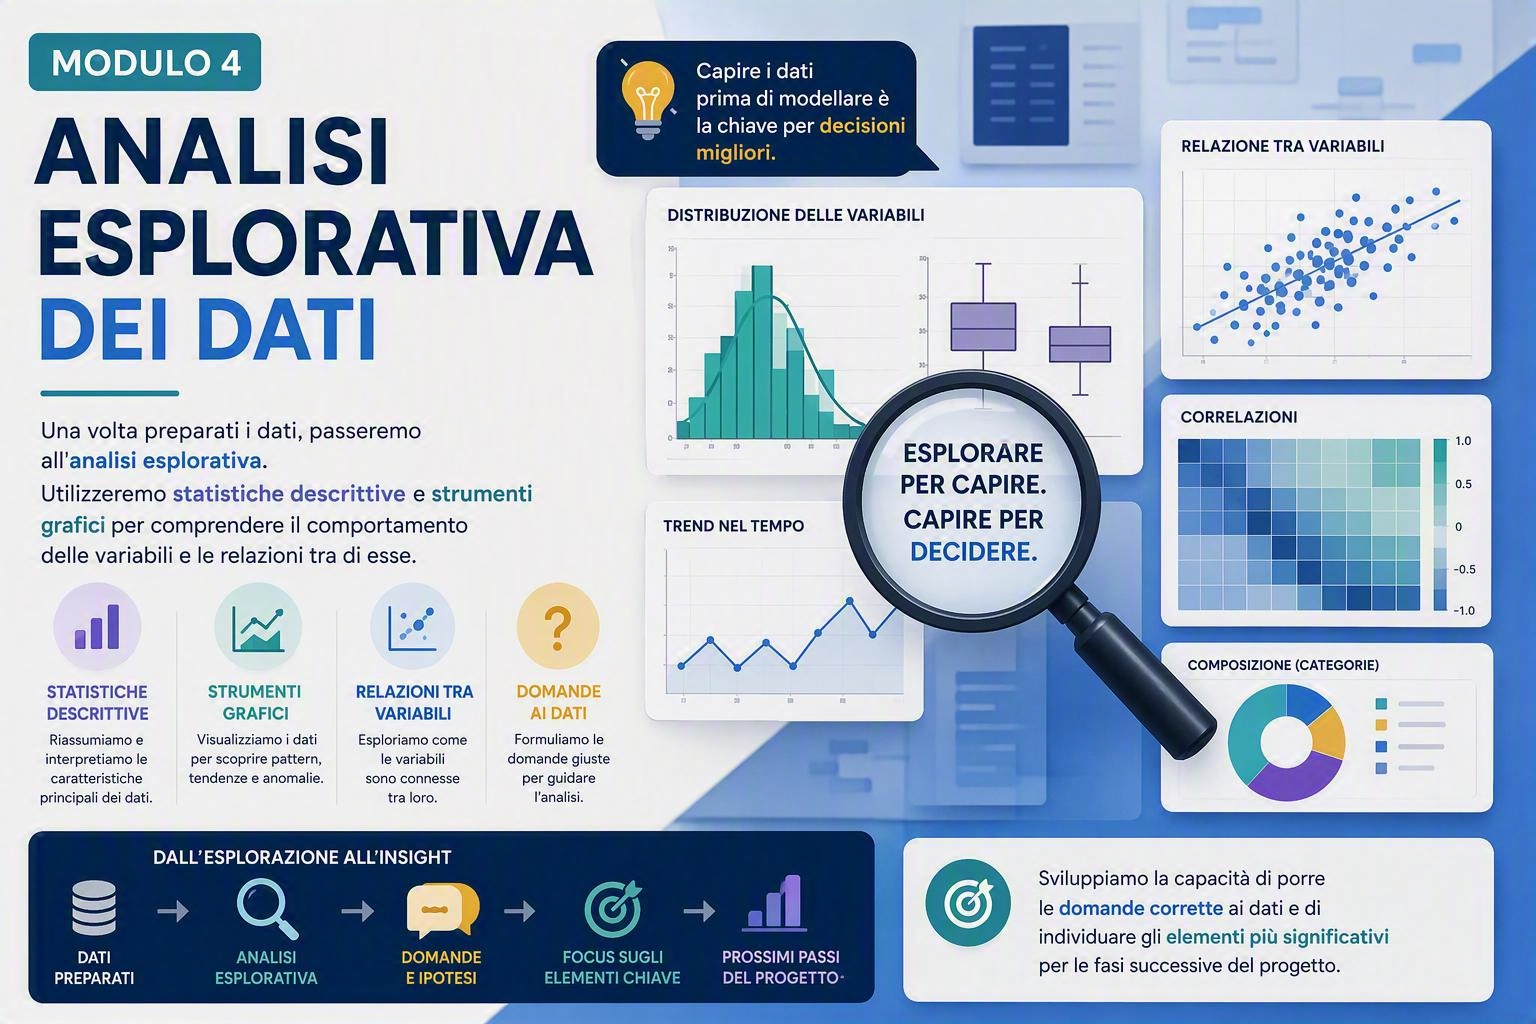
Modulo 4
Analisi esplorativa dei dati
Una volta preparati i dati, passeremo all'analisi esplorativa. Utilizzeremo statistiche descrittive e strumenti grafici per comprendere il comportamento delle variabili e le relazioni tra di esse. Questo modulo ci aiuterà a sviluppare la capacità di porre le domande corrette ai dati e di individuare gli elementi più significativi per le fasi successive del progetto.
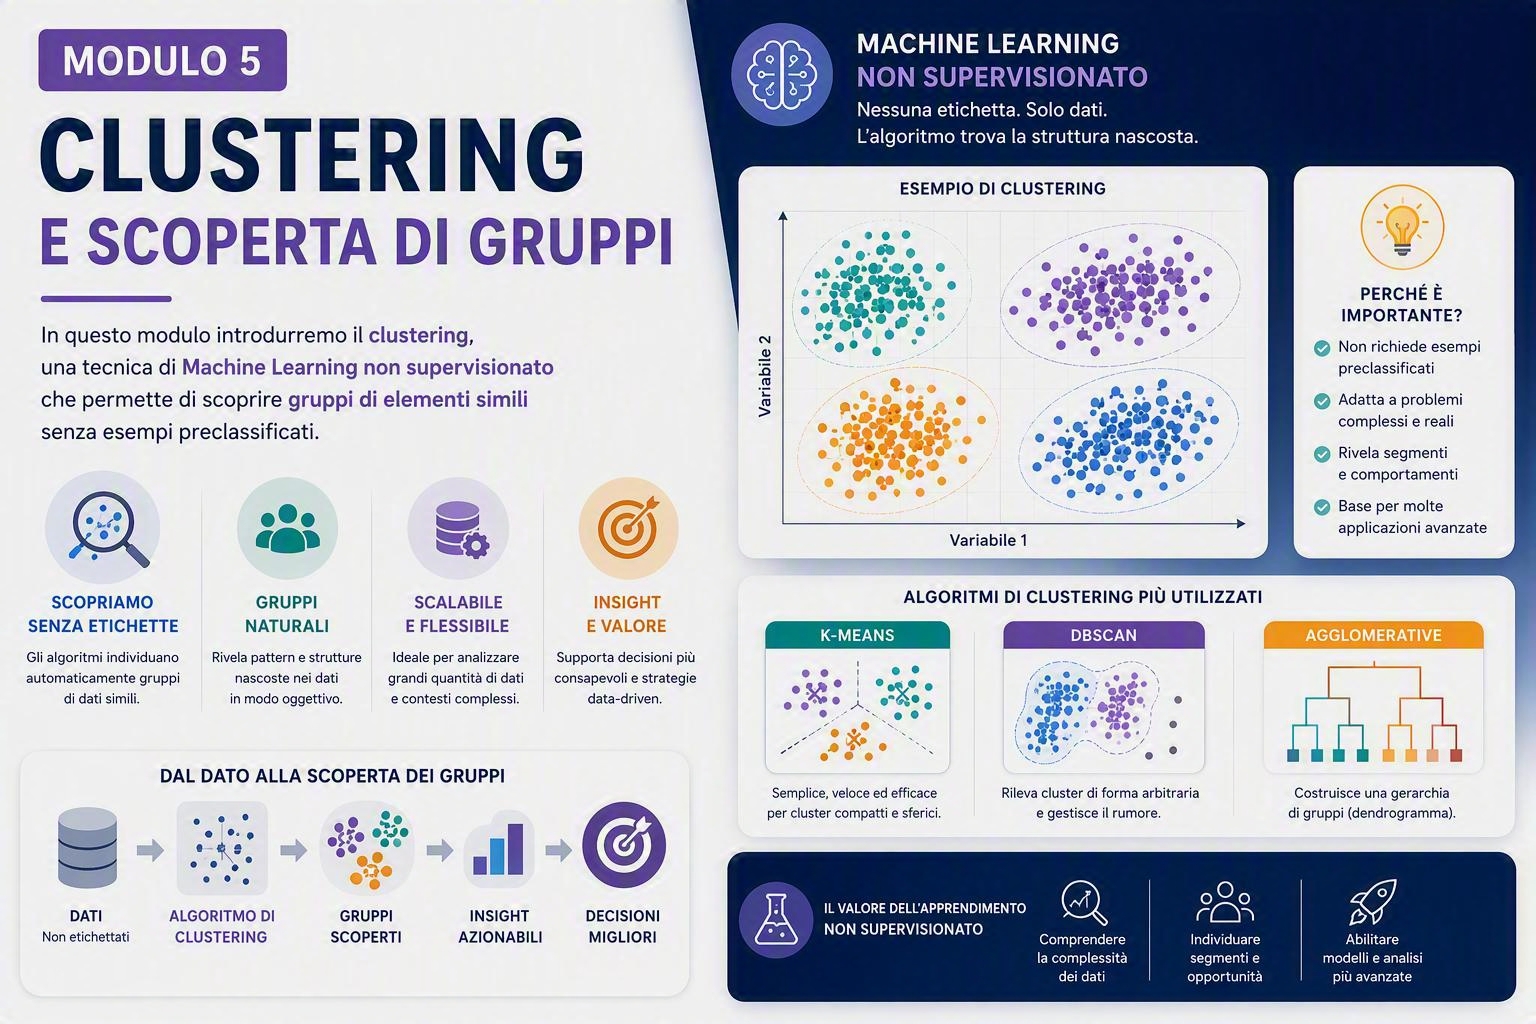
Modulo 5
Clustering e scoperta di gruppi
In questo modulo inizieremo a introdurre alcuni concetti fondamentali del Machine Learning attraverso il clustering. Scopriremo come gli algoritmi possano individuare automaticamente gruppi di elementi simili senza ricevere esempi preclassificati. Comprenderemo il valore dell'apprendimento non supervisionato e la sua utilità nell'analisi di grandi quantità di dati.
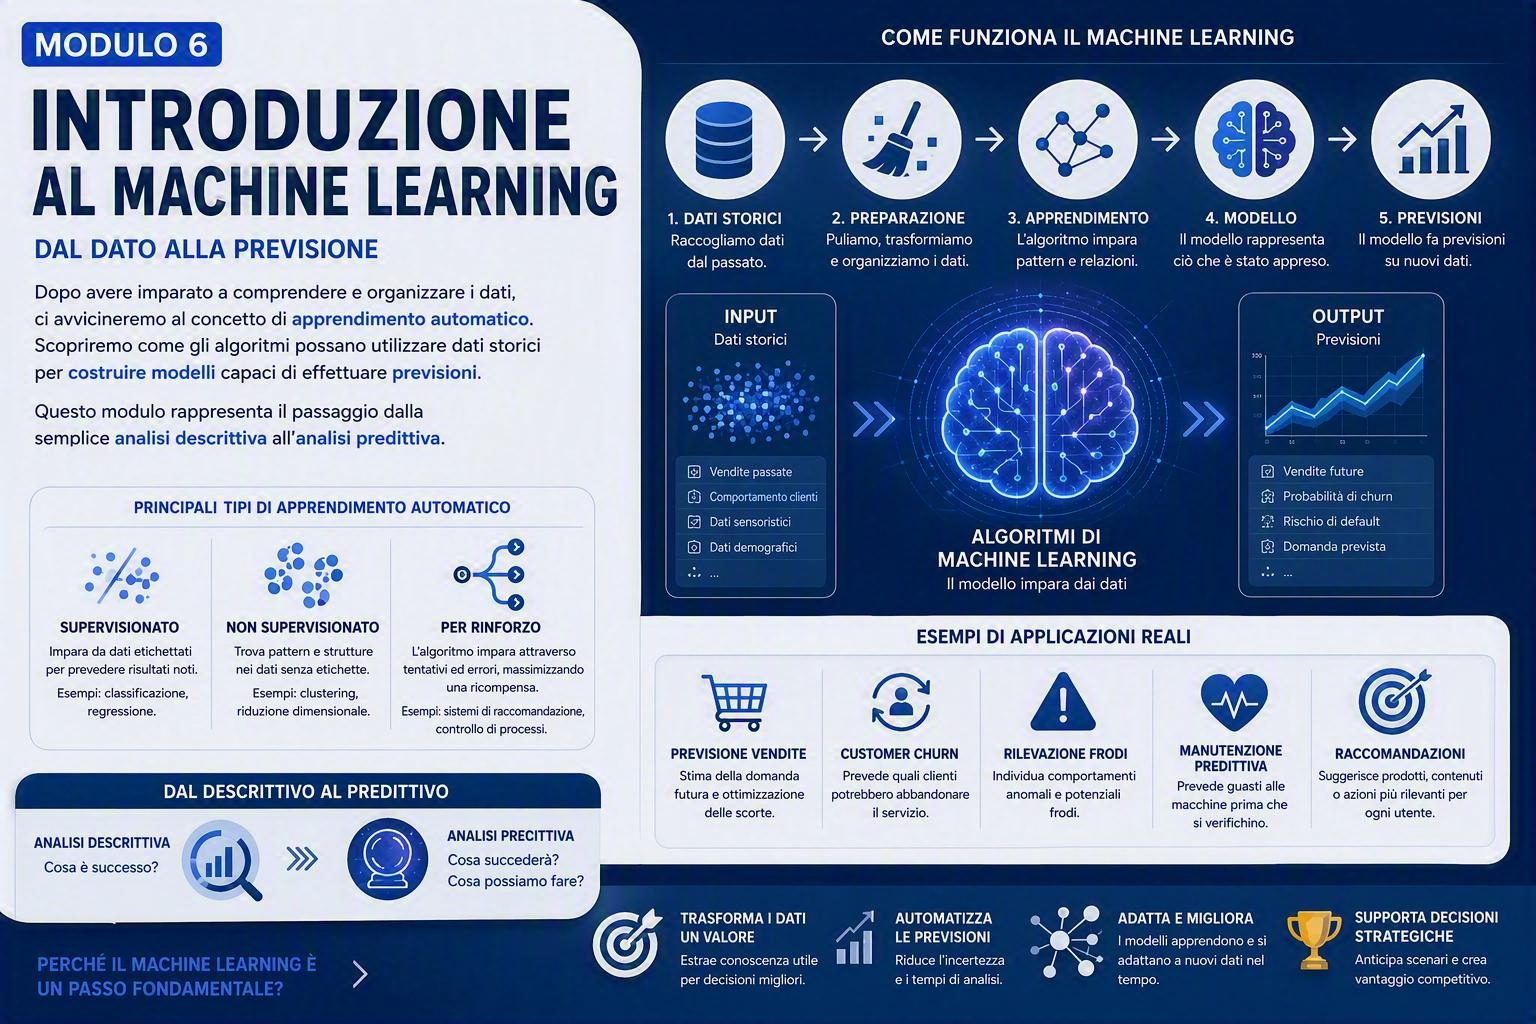
Modulo 6
Introduzione al Machine Learning
Dopo avere imparato a comprendere e organizzare i dati, ci avvicineremo al concetto di apprendimento automatico. Scopriremo come gli algoritmi possano utilizzare dati storici per costruire modelli capaci di effettuare previsioni. Questo modulo rappresenta il passaggio dalla semplice analisi descrittiva all'analisi predittiva.
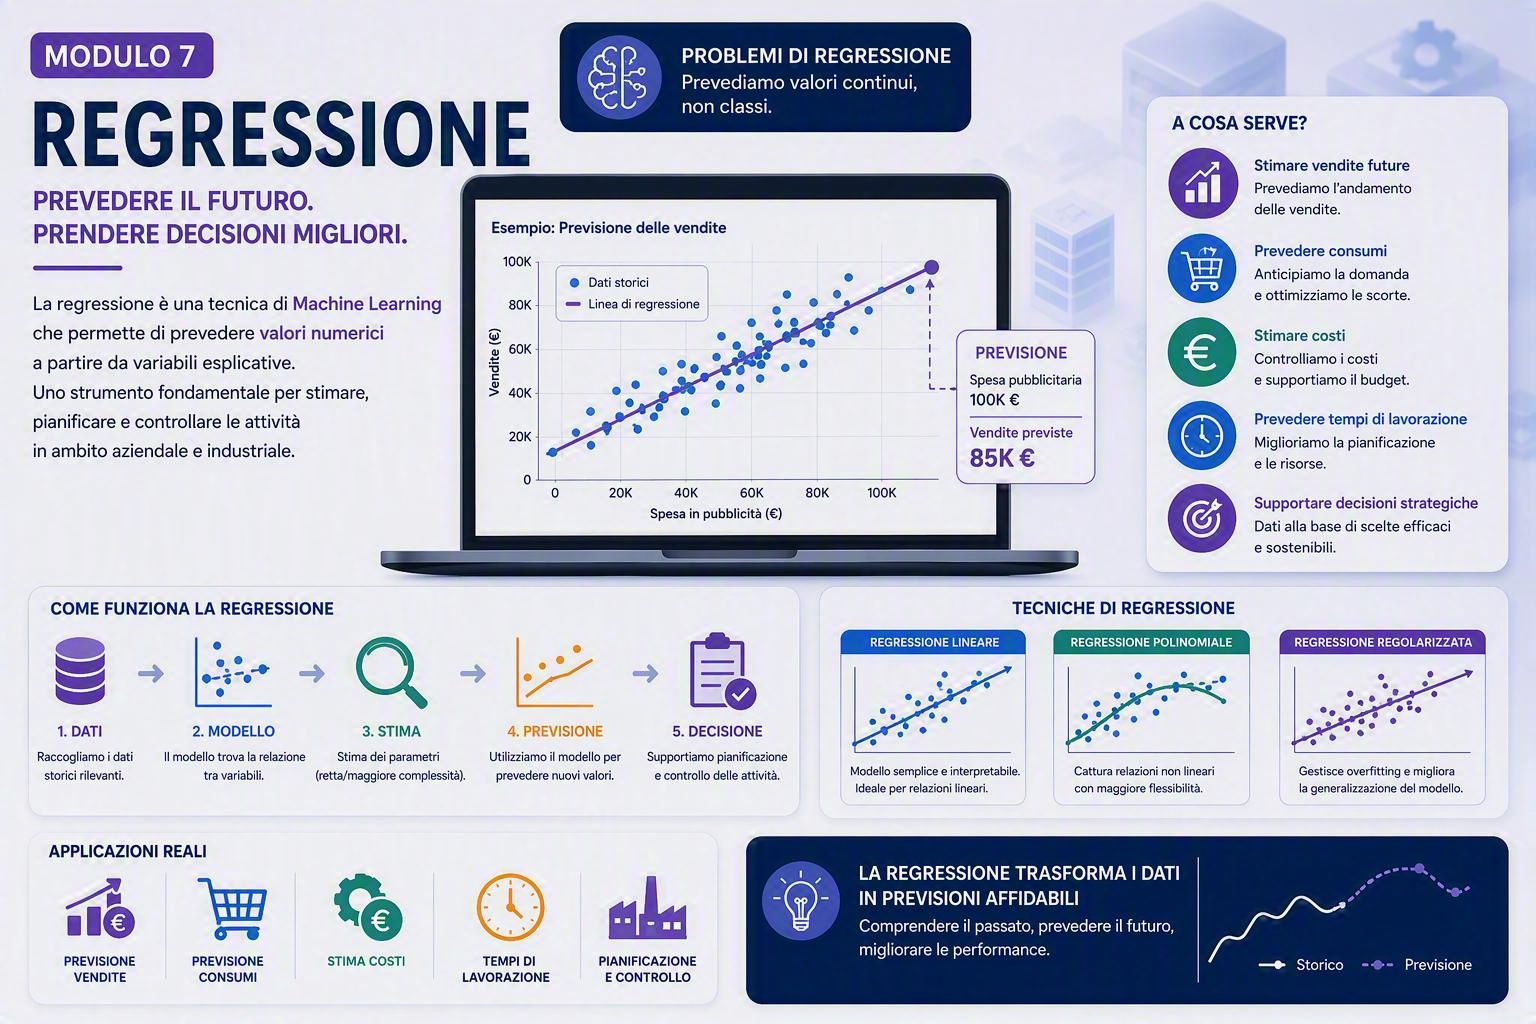
Modulo 7
Regressione
In questo modulo ci concentreremo sui problemi che richiedono la previsione di valori numerici. Impareremo come stimare vendite future, consumi, costi, tempi di lavorazione e altri indicatori quantitativi. La regressione costituisce una delle tecniche più diffuse nel mondo aziendale e industriale per supportare la pianificazione e il controllo delle attività.
Modulo 8
Classificazione
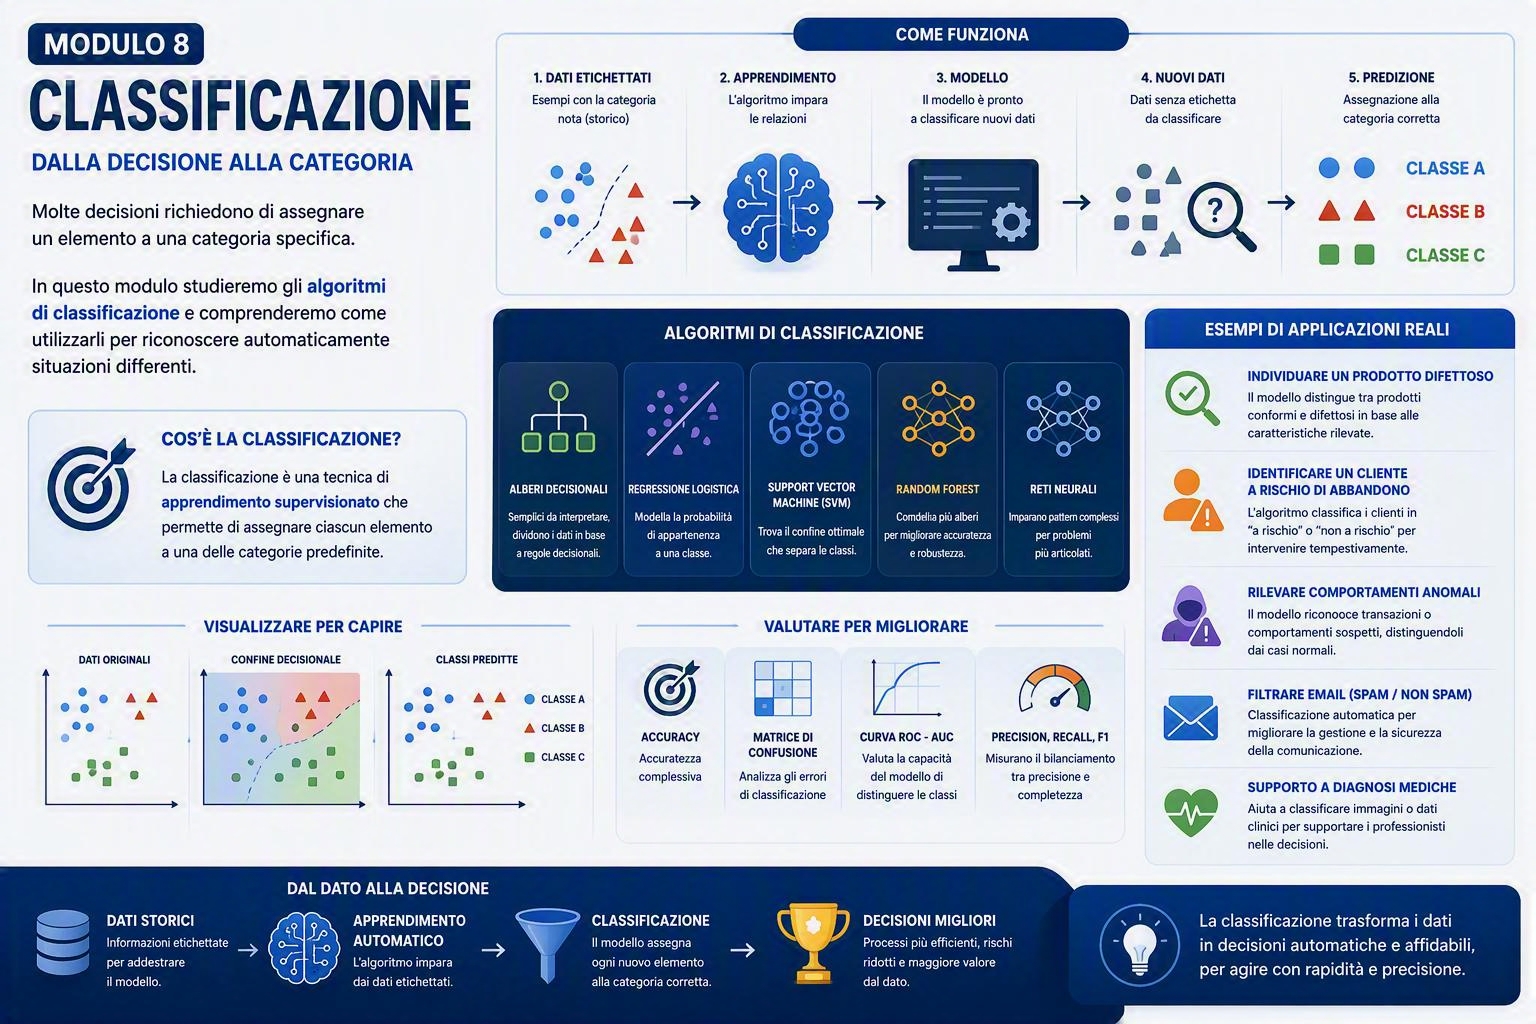
Molte decisioni richiedono di assegnare un elemento a una categoria specifica. In questo modulo studieremo gli algoritmi di classificazione e comprenderemo come utilizzarli per riconoscere automaticamente situazioni differenti, come individuare un prodotto difettoso, identificare un cliente a rischio di abbandono o rilevare comportamenti anomali.
Modulo 9
Valutazione dei modelli
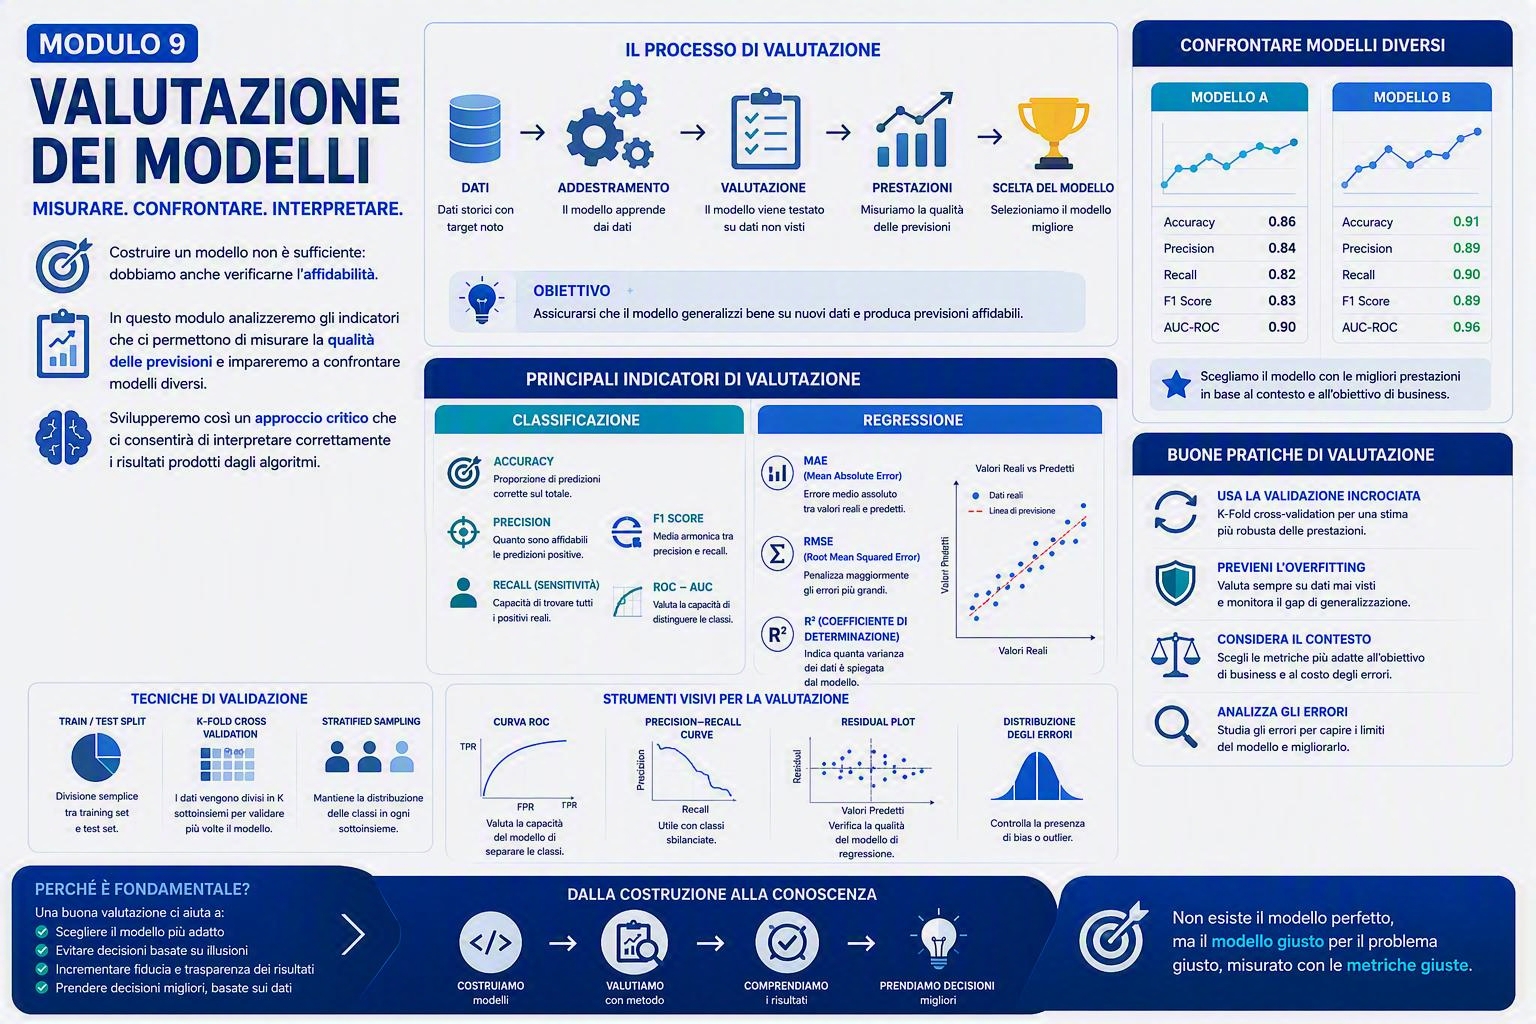
Costruire un modello non è sufficiente: dobbiamo anche verificarne l'affidabilità. In questo modulo analizzeremo gli indicatori che ci permettono di misurare la qualità delle previsioni e impareremo a confrontare modelli diversi. Svilupperemo così un approccio critico che ci consentirà di interpretare correttamente i risultati prodotti dagli algoritmi.
Modulo 10
Project work finale
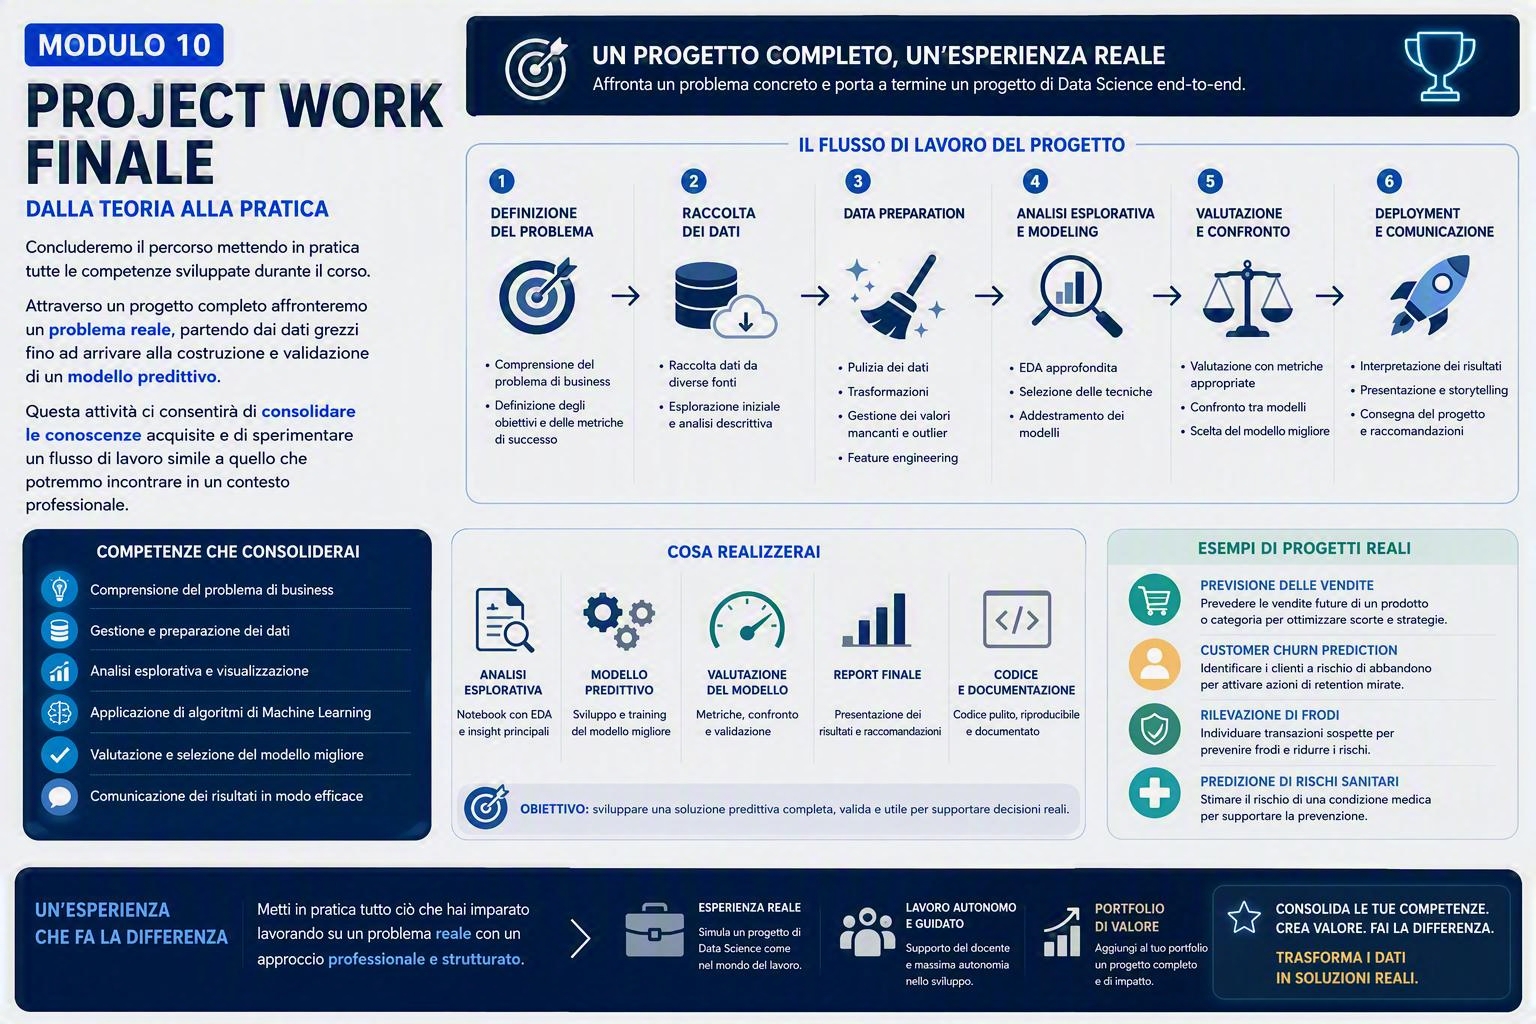
Concluderemo il percorso mettendo in pratica tutte le competenze sviluppate durante il corso. Attraverso un progetto completo affronteremo un problema reale, partendo dai dati grezzi fino ad arrivare alla costruzione e validazione di un modello predittivo. Questa attività ci consentirà di consolidare le conoscenze acquisite e di sperimentare un flusso di lavoro simile a quello che potremmo incontrare in un contesto professionale